Este guia analisa o uso de “Scenario Automação” para organizar, validar e otimizar fluxos de produção com segurança e rastreabilidade. Em seguida, contextualiza de forma objetiva como cenários, regras e integrações impactam a operação industrial: padronização, redução de variações, governança de mudanças e métricas de desempenho baseadas em relatórios técnicos e práticas consagradas.
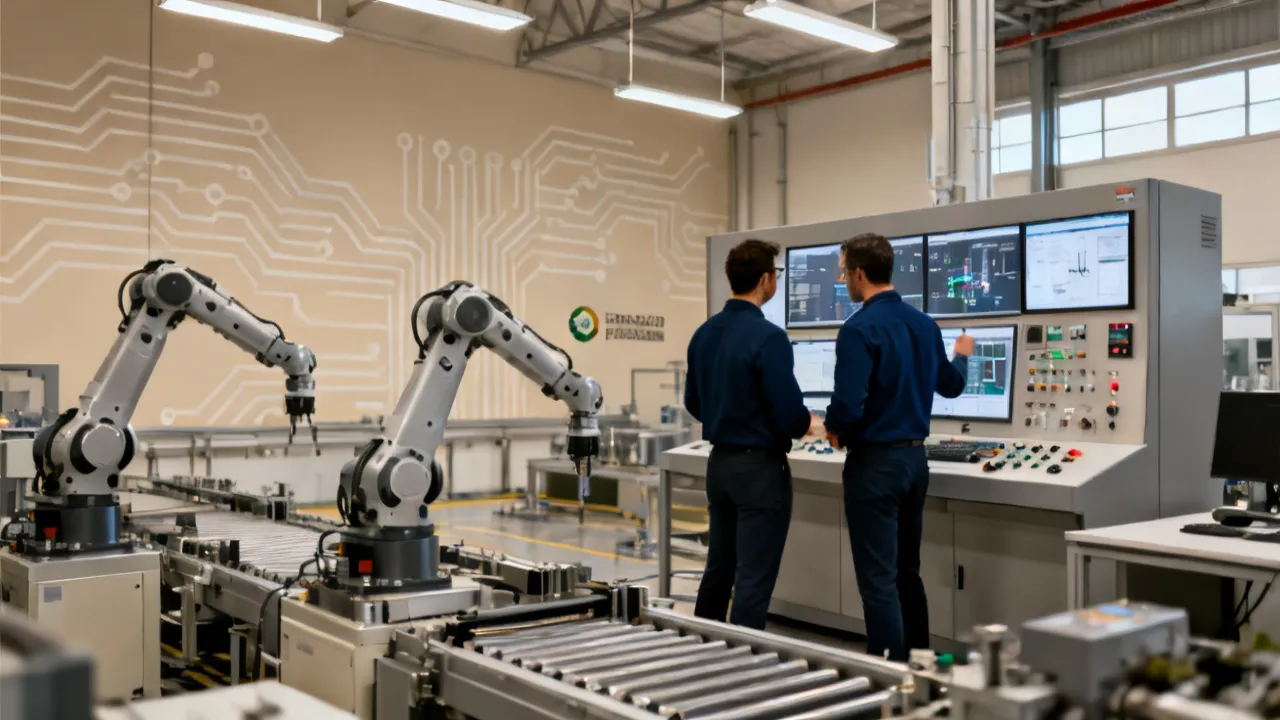
Em projetos de automação, o termo Scenario Automação costuma aparecer quando o objetivo é estruturar comportamentos do sistema por contexto operacional: partida, parada, troca de lote, falha, modo de manutenção, variações de produto e contingências. Quando bem desenhados, esses cenários oferecem governança, rastreabilidade e uma forma consistente de implementar mudanças sem “surpresas” na linha. Quando mal definidos, viram um conjunto de scripts soltos que aumentam o tempo de parada e dificultam a validação.
O ponto crítico, portanto, é tratar cenário como artefato de engenharia: com requisitos claros, condições de ativação, critérios de sucesso, logs e integração com os componentes do processo (CLPs/SCADA/MES/Historiadores e controladores de segurança). É assim que Scenario Automação deixa de ser apenas uma ideia de “rotina” e se torna um método para reduzir variação operacional e aumentar previsibilidade.
Para perceber onde a diferença nasce, vale olhar para dois estilos comuns de construção de automação. O primeiro é o “estilo funcional”, no qual o sistema é descrito por lógicas e blocos cujo comportamento final emerge de interações complexas entre permissivos, setpoints, rampas e temporizações. O segundo é o “estilo por cenários”, no qual o comportamento é apresentado como sequências e estados com regras de transição declaradas. Em geral, a desordem aparece quando o projeto tenta mesclar ambos sem definir claramente quem “manda” na transição de estados e quais requisitos devem ser respeitados em cada etapa.
Uma pergunta prática para identificar se o seu cenário está caminhando para melhoria ou desordem é: se alguém novo chegasse ao time amanhã, conseguiria entender o que o sistema faz apenas lendo o cenário? Se a resposta for “não”, é sinal de que há lacunas de documentação, de critérios de sucesso e/ou de desenho de transições. Outra pergunta útil: os alarmes e logs apontam para o cenário correto? Se os alarmes não “anotam” o contexto, a operação tende a virar caçadores de causa, e a engenharia começa a perder tempo diagnosticando algo que deveria estar evidente no artefato.
Por fim, existe uma distinção importante: cenários são governança do comportamento, não apenas organização do código. Dá para reestruturar código sem criar cenários; dá para criar “estados” sem critérios e sem governança. O que diferencia, na prática, é: definição formal de gatilhos e condições; regras determinísticas; validação baseada em requisitos; e mecanismos para lidar com falhas de maneira reprodutível.
No uso cotidiano, Scenario Automação representa uma forma de organizar lógicas e estados do sistema para diferentes condições. Em vez de o operador “adivinhar” como o software deveria se comportar, o sistema passa a seguir uma sequência previamente validada, com regras de transição e validações técnicas.
Ao longo de projetos, esse conceito se conecta a temas como:
Em termos objetivos, cenário é a ponte entre o “como o processo deveria funcionar” e o “como o software efetivamente se comporta”, cobrindo tanto condições normais quanto exceções.
Para tornar essa definição mais tangível, é comum que cenários sejam expressos como: uma máquina de estados (mesmo que implícita), um conjunto de regras (habilitações e critérios de passo) e um mapeamento entre eventos do mundo real (sensores, comandos do HMI, mudança de receita/lote, disponibilidade de utilidades) e as ações que a automação deve executar.
Em plantas reais, existem pelo menos cinco “classes” de eventos que costumam acionar cenários:
Ao desenhar cenários, o ideal é que o comportamento responda de forma coerente a cada classe de evento. Por exemplo: uma perda de utilidade pode exigir “pausa controlada” e depois retorno; uma falha de segurança pode exigir “parada segura” sem retorno automático. Se o mesmo tipo de evento desencadear reações inconsistentes, a operação perde confiança e os tempos de correção aumentam.
Além disso, “Scenario Automação” costuma ser confundido com “processo” (a receita industrial) ou com “workflow” (o fluxo do MES). A diferença é que cenário é o comportamento executável do sistema de controle/supervisão em cada estado, enquanto processo/receita define parâmetros e metas, e workflow define etapas de negócio. O cenário precisa “orquestrar” essas camadas, mas não substituí-las. O melhor desenho é aquele que respeita a responsabilidade de cada nível.
Uma automação organizada por cenários tende a melhorar três frentes: segurança, qualidade e continuidade.
Segurança: bons cenários tratam intertravamentos como parte do fluxo. Em vez de permissivos ficarem “espalhados” por blocos, eles são declarados e verificados no momento certo. Isso facilita auditoria e reduz risco de lógica incompleta.
Qualidade: quando o cenário define critérios de aceite (por exemplo, faixas de temperatura, rampas, tempos mínimos e máximos), o sistema reduz a chance de produzir fora de especificação por sequência incorreta. Além disso, logs permitem identificar exatamente em que momento a condição se desviou.
Continuidade: cenários bem amarrados aceleram diagnósticos. Em uma parada, por exemplo, o time pode identificar o cenário ativo, a causa provável e a sequência recomendada de retorno — em vez de reconstruir mentalmente o estado do sistema.
Para ampliar essa visão, vale detalhar como cada frente ganha robustez.
Segurança funcional e previsibilidade de resposta
Em muitas plantas, os intertravamentos de segurança existem em camadas distintas: hardware (relés de segurança, sensores dual-channel), lógica de segurança (controller safety) e lógica de automação (controle “normal”). O cenário precisa ser o “contrato” que liga o que o processo exige ao que o sistema pode fazer com segurança.
Por exemplo, se a área exige que a porta do acesso esteja fechada para iniciar aquecimento, o cenário deve:
Sem cenário, a lógica de permissivos pode existir, mas o comportamento em “meio da execução” fica ambíguo. Isso é especialmente crítico em operações com rampas e etapas energéticas (aquecimento, pressurização, movimentação com risco mecânico). Cenário reduz a chance de “fazer parcialmente” algo perigoso.
Qualidade como produto de sequência e condições
Qualidade não depende apenas de valores finais (ex.: temperatura atingida), mas também de como se chegou lá. Cenários ajudam a garantir que:
Um exemplo comum é o uso de válvulas de controle para dosagem. Um cenário “por tentativa” pode permitir que o sistema avance para a etapa seguinte quando o sensor “parece” em faixa, mas sem verificar se houve estabilidade por tempo mínimo. O cenário, por sua vez, pode especificar: “a variável deve permanecer dentro da banda por X segundos antes de liberar a próxima etapa”. Essa é uma forma concreta de transformar critérios em comportamento.
Continuidade e redução de downtime improdutivo
Continuidade operacional é, em essência, redução de downtime sem perder segurança e qualidade. Cenários contribuem porque tornam diagnósticos mais rápidos. Para isso, o cenário precisa estar conectado à observabilidade: não basta rodar, precisa ser “explicável”. Em uma parada, o time pergunta: “Em que estado estava?” e “Por qual regra saiu do fluxo?”. Se o sistema mostra “SCN_TROCA_LOTE” ativo, com código do motivo (ex.: permissivo X ausente) e timestamp, a investigação se torna mais direta.
Além disso, cenários permitem a criação de comportamentos de recuperação. Dependendo da criticidade, pode-se ter:
Esses comportamentos evitam o ciclo típico “desliga, liga, tenta de novo”, que costuma criar variabilidade e aumenta risco de incidentes e perdas de lote.
Do ponto de vista de engenharia, um bom Scenario Automação começa por requisitos. A prática recomendada é definir:
Esse enfoque ajuda a evitar um erro recorrente: “programar primeiro” e tentar validar depois. Em automação, a validação posterior quase sempre custa mais tempo e aumenta o risco de retrabalho.
Para dar robustez a esse requisito-first approach, é útil detalhar o formato de requisitos de cenário. Na prática, requisitos bons são verificáveis. Isso significa que cada item do cenário deve ter uma forma de testar e aceitar/rejeitar. Alguns exemplos de requisitos verificáveis:
Observe que requisitos acima não são “literatura”. Eles descrevem condições e comportamentos testáveis.
Além disso, requisitos de cenário devem prever modos operacionais. Um cenário pode ter variações por modo (manual, semiautomático, automático, manutenção). Por isso, um bom documento de cenário normalmente inclui uma matriz de habilitação por modo:
Sem isso, a operação pode “furar” o controle do engenheiro por ações aparentemente simples, como trocar modo para resolver um problema rápido — e causar instabilidade no fluxo.
Por fim, a fase de requisitos também deve abordar efeitos colaterais. Em automação, um cenário não apenas “faz algo”; ele também altera variáveis e escreve registros (por exemplo, marca lote como “iniciado”, muda flags de qualidade, atualiza contadores). Se esses efeitos não forem especificados, o sistema pode ficar inconsistente com o MES e dificultar rastreabilidade.
Em projetos típicos, o desenho de cenários deve refletir a arquitetura existente. Um padrão frequentemente observado é separar responsabilidades:
O especialista em automação tende a priorizar uma regra simples: cenário não pode ser “duplicado” em múltiplos lugares com lógica divergente. Se a supervisão e o controle decidem estados de forma incompatível, o resultado é instabilidade e alarmes difíceis de interpretar.
Essa discussão é especialmente importante em integrações modernas. Muitos projetos têm histórico de “evolução orgânica” e, ao longo do tempo, passaram a colocar lógica em lugares diferentes. Quando o time tenta introduzir cenários, precisa resolver o problema de “fonte de verdade” (source of truth): quem define o estado real do cenário?
Uma forma prática de reduzir risco é aplicar o princípio:
Assim, o SCADA não inventa estados: ele traduz o estado real para HMI, alarmes e logs. O MES não muda comportamento do controle; ele registra eventos e pode sinalizar regras de negócio que influenciam setpoints ou permissivos, mas não deve reescrever a máquina de estados do CLP.
Entretanto, há casos em que o cenário pode se desdobrar em “subcenários” distribuídos. Por exemplo:
Nesses casos, precisa existir uma “tabela de contratos” entre camadas: quais flags indicam estados, quais códigos de motivo são padronizados, e quais eventos são considerados “conclusão”.
Outro ponto arquitetural relevante é a granularidade. Se os cenários são grandes demais, o sistema fica difícil de testar e evoluir. Se são pequenos demais, vira excesso de estados, e o time perde tempo criando transições para casos quase idênticos. Por isso, em geral recomenda-se definir cenários em níveis como:
Essa hierarquia reduz complexidade cognitiva. A operação vê “Produção”, mas a engenharia consegue testar “Aquecimento” e validar “estabilidade por tempo mínimo” sem depender de adivinhação.
Quando se fala em Scenario Automação, testes devem ser guiados pelo que o cenário declara. Em vez de testar apenas o fluxo principal, a cobertura precisa incluir:
Esse tipo de abordagem se alinha ao que relatórios e guias técnicos de qualidade de software industrial defendem: testes baseados em critérios e requisitos reduzem risco e melhoram reprodutibilidade. Como referência conceitual para práticas de engenharia de segurança e controle, é comum consultar materiais como normas e guias adotados no setor (por exemplo, séries IEC e recomendações de ciclo de vida de sistemas). Para gerenciamento de requisitos e rastreabilidade de mudanças, práticas consagradas também são discutidas em organismos de referência como o SEI (Software Engineering Institute), que publica relatórios sobre maturidade e engenharia de software.
Para ampliar a seção de testes, é útil separar testes em camadas, alinhadas à arquitetura: testes de unidade (lógica local), testes de integração (CLP com I/O e segurança), testes de sistema (com SCADA e interface do operador) e testes com rastreabilidade (com MES/Historiador quando aplicável).
1) Testes de unidade por critérios
Mesmo sendo automação industrial, dá para fazer “unidade” quando o cenário é construído em módulos. Por exemplo:
O objetivo é reduzir o espaço de busca quando algo falha. Se o teste de unidade já garante que a lógica de estabilidade funciona, então problemas em sistema tendem a ficar mais isolados.
2) Testes de integração com I/O e simulação
Em cenários, a integração com sensores é onde muitos erros aparecem: escalas diferentes, sinal invertido, valores “fantasma”, cabos fora de faixa, intermitência. Uma estratégia de teste baseada em cenário define:
Para reduzir trabalho manual, a planta pode utilizar simuladores de I/O e/ou sistemas de injeção de falhas em ambiente de FAT. Mesmo quando não existe simulador completo, o ideal é que a lógica de cenário seja configurável para aceitar valores “de teste” (com proteção de segurança para não afetar operação real).
3) Testes de sistema com HMI/SCADA
Em SCADA, o risco comum é que a interface operacional não reflita o estado do controle. O teste por cenário deve incluir o que o operador vê e faz:
Um caso típico: o SCADA exibe “aguardando operador”, mas o controle está em “falha de permissivo”. O operador tenta corrigir algo que não resolve. Esse tipo de divergência deve ser detectado em testes.
4) Testes de rastreabilidade e evidência
Se o cenário se conecta ao MES/histórico, os testes também precisam validar que os eventos foram registrados com consistência. Por exemplo:
Isso é crucial quando o cliente exige auditoria ou quando a análise posterior precisa de evidências para liberar produção, investigar desvio ou justificar retrabalho.
Além disso, testes por cenário normalmente exigem uma matriz de cobertura. Uma matriz útil é aquela que cruza: cenários x tipos de falha x modo operacional x expectativa de comportamento (o que o sistema deve fazer). Sem essa matriz, a cobertura fica dependente da memória do time e aumenta variabilidade de execução.
Quando clientes perguntam por preço relacionado a Scenario Automação, a resposta correta quase nunca é um número fixo. O custo costuma depender de fatores como:
Assim, o mercado normalmente trabalha com orçamentos por projeto. Para obter uma proposta tecnicamente comparável, o fornecedor deve detalhar escopo, entregáveis, cronograma, critérios de aceite e responsabilidades (por exemplo, quem fornece ambientes de teste e quem valida resultados). Se existir um fornecedor específico na sua cadeia (por exemplo, integrador local ou fabricante de automação), esses dados devem ser informados no briefing para reduzir retrabalho.
Em qualquer cenário comercial, a recomendação é exigir que a proposta inclua:
Para tornar a conversa de orçamento mais produtiva e evitar “suposições”, costuma ajudar o cliente a preparar um documento de briefing com informações mínimas:
Com esses itens, o fornecedor consegue estimar melhor esforço e reduzir risco de divergência de escopo. Sem isso, o custo tende a ser “inflado” por incerteza, o que não é desejável para ninguém.
Outro ponto comercial relevante é a composição do esforço. Muitos projetos subestimam atividades como:
Ao mesmo tempo, projetos que focam apenas em “código” e ignoram documentação e testes frequentemente atrasam ou geram retrabalho na comissionamento.
Assim, um orçamento tecnicamente sólido para “Scenario Automação” geralmente deixa claro quais responsabilidades são do fornecedor e quais são do cliente, por exemplo:
Se a sua iniciativa está voltada a operações nearby (por exemplo, unidades industriais na mesma região), a vantagem prática costuma ser a disponibilidade do time para visitas técnicas, inspeções de planta e reuniões de alinhamento. Em termos culturais de operação, equipes industriais em regiões com forte presença de serviços técnicos geralmente valorizam:
Em outras palavras, além do componente técnico, a adoção do método de cenários tende a funcionar melhor quando existe integração entre engenharia, operação e manutenção — especialmente quando a equipe consegue operar perto do chão de fábrica e manter ciclos de melhoria curtos.
Para aproveitar essa proximidade, é comum criar rotinas de acompanhamento que “fecham o ciclo” de melhoria contínua. Um exemplo prático:
Em operações próximas, o ganho é que o time consegue fazer “link” entre evidência e ajuste. Quando a equipe tem pouca disponibilidade e o suporte é distante, o processo de correção tende a ser mais lento e reativo.
Também vale considerar a cultura de padronização. Se cada unidade tem pequenas variações de processo, os cenários podem ser reaproveitados com parametrização, mas a governança precisa definir:
Uma abordagem madura cria um “catálogo” de cenários e uma estrutura de templates para acelerar implementação em unidades similares. Isso não significa que tudo será idêntico; significa que a lógica base de governança e observabilidade é reutilizada com controle.
| Elemento | Abordagem recomendada para Scenario Automação | O que evitar (risco típico) |
|---|---|---|
| Definição do cenário | Escopo claro, gatilhos, condições, sequência e critérios de sucesso | Lógica difusa, múltiplas versões do “mesmo” cenário |
| Integração com controle | Responsabilidades separadas e consistentes entre controle e supervisão | Divergência de estados entre camadas |
| Observabilidade | Logs por evento e correlação com lote/produto quando aplicável | Apenas alarmes sem contexto operacional |
| Tratamento de falhas | Comportamento determinístico com retorno controlado quando possível | Falhas “silenciosas” ou paradas sem orientação |
| Validação | Testes baseados em critérios e requisitos (cobertura de exceções) | Validação limitada ao fluxo nominal |
Fonte (referencial de boas práticas): Para sustentar práticas de qualidade, rastreabilidade e maturidade em engenharia de software, recomenda-se consultar publicações do SEI (Software Engineering Institute) e diretrizes de ciclo de vida e qualidade frequentemente adotadas no setor industrial. Para aspectos de segurança funcional, em geral utiliza-se a família IEC como referência normativa no desenvolvimento e validação de sistemas de controle e segurança. (A aplicação exata depende do seu contexto e deve ser verificada com a engenharia responsável.)
Para ampliar a utilidade da tabela acima, é interessante transformar cada “evitar” em um “checklist de detecção”. Assim, durante revisões técnicas, o time pode perguntar:
Esse checklist reduz a chance de “passar por alto” pontos críticos que normalmente aparecem tarde, quando já é caro corrigir.
Para transformar esse passo a passo em um método mais “operacional”, convém detalhar cada etapa com exemplos e outputs esperados. A ideia é que, ao final de cada passo, exista um artefato concreto que ajude o projeto a avançar.
Passo 1: Mapear os modos operacionais (saída esperada)
Saída esperada: uma lista de modos e regras de transição. Por exemplo:
Quando mapear modos, é importante listar também o que não pode acontecer. Por exemplo: “não é permitido iniciar produção em MANUTENCAO” ou “não é permitido alterar receita durante execução de etapa crítica”. Esse “não pode” é uma parte essencial do requisito.
Passo 2: Definir a taxonomia de cenários (saída esperada)
Saída esperada: um catálogo de cenários com nome, descrição curta e categorias (macro e micro). Exemplo:
Uma boa taxonomia reduz o risco de “nomear errado”. Se o mesmo estado é chamado por nomes diferentes em SCADA, logs e documentação, o time perde rastreabilidade. Portanto, taxonomia também é uma ferramenta de consistência.
Passo 3: Escrever requisitos por cenário (saída esperada)
Saída esperada: uma ficha por cenário com campos padronizados: escopo, gatilhos, pré-requisitos, sequência, critérios de sucesso, falhas, saídas/efeitos e auditoria.
Para aumentar a qualidade, cada campo deve ter:
Passo 4: Projetar transições (saída esperada)
Saída esperada: um diagrama simples (texto e/ou estados) com regras do tipo: “ao sair de A para B, executar ações X e validar Y”. Essa etapa inclui também:
Um método para esclarecer simultaneidade é definir a prioridade. Por exemplo:
Sem prioridades definidas, a máquina de estados pode apresentar comportamento não determinístico em condições raras.
Passo 5: Implementar no nível correto (saída esperada)
Saída esperada: especificação de responsabilidades e implementação verificável. O que documentar:
Além disso, recomenda-se estabelecer um “contrato de tags”, isto é, uma lista de tags e seus significados. Por exemplo:
SCN_ACTIVE_ID: identificador do cenário em execução;SCN_STEP_ID: etapa interna (se aplicável);SCN_MOTIVE_CODE: motivo de falha ou motivo de transição;SCN_EXEC_START_TS: timestamp de início; SCN_LAST_TRANSITION_TS: timestamp da última transição.Com esse contrato, a equipe de SCADA e o time de integração conseguem alinhar sem divergências.
Passo 6: Padronizar nomenclatura e logs (saída esperada)
Saída esperada: padrão de log e alarm. Isso inclui:
Um bom padrão de logs reduz o tempo de diagnóstico em falhas “difíceis”. Se o log mostra o valor atual e o limite configurado, muitas vezes dispensa coleta manual.
Passo 7: Montar matriz de testes (saída esperada)
Saída esperada: tabela que cruza cenário x tipo de teste. Exemplos de tipos:
A matriz deve indicar expectativa e evidência. “Evidência” pode ser: tags mudaram para estado X, alarm A1 disparou, log registrou motivo Y, etc.
Passo 8: Executar validação em ambiente de teste (saída esperada)
Saída esperada: relatórios de evidência. A validação em ambiente de teste é o momento para corrigir problemas antes de planta. É também onde ajustes de requisitos são feitos sem custo de downtime real.
Passo 9: Executar FAT/SAT quando aplicável (saída esperada)
Saída esperada: prova formal do que foi contratado. FAT (Factory Acceptance Test) e SAT (Site Acceptance Test) devem demonstrar cenários e critérios de sucesso/fracasso. Documentação é chave para que o cliente não tenha surpresas.
Passo 10: Treinar operação e manutenção (saída esperada)
Saída esperada: material de treinamento e sessão de hands-on. A formação precisa cobrir:
Treinamento reduz a chance de o operador “contornar” o processo por instinto durante falhas.
Passo 11: Revisar pós-comissionamento (saída esperada)
Saída esperada: plano de melhoria e atualização de cenários com base em ocorrências reais. Esse passo é onde a maturidade surge: cenários deixam de ser apenas entrega e passam a ser instrumento de aprendizado contínuo.
Para aprofundar, é comum que rollouts de cenários falhem por motivos operacionais e não apenas técnicos. Por exemplo:
Assim, rollout bem-sucedido também é processo. Alguns requisitos de rollout incluem:
Também é importante tratar o tema de “configuração” versus “programação”. Muitos cenários dependem de parâmetros: limites, tempos e setpoints. Um bom rollout define:
Sem isso, o cenário vira um conjunto de constantes “fixas no código”, e toda melhoria vira reprogramação. Ou, no extremo oposto, o cenário vira totalmente configurável sem controle, aumentando risco de uso incorreto.
É comum querer “estatísticas” de resultado ao adotar Scenario Automação. Contudo, números absolutos variam muito entre plantas. Para evitar conclusões não verificadas, o ideal é medir indicadores que façam sentido para seu contexto, como:
Para metodologias de métricas e maturidade de processos, relatórios de engenharia de software e qualidade (como os do SEI) são frequentemente usados como base para estruturar como medir e melhorar. Já para segurança funcional, a referência normativa e os relatórios de engenharia do projeto determinam como tratar validade, auditoria e evidências.
Para tornar as métricas mais úteis, é importante definir o que elas significam e como são calculadas. Caso contrário, a empresa pode medir “algo” e tomar decisões erradas.
MTTD (Mean Time To Diagnose)
MTTD mede o tempo entre o início de uma falha (ou alarme crítico) e a identificação da causa provável ou do cenário/motivo correto. Para isso, é essencial que os logs associem o evento ao cenário e ao motivo. Caso contrário, o tempo de diagnóstico pode continuar alto mesmo com “cenários”, e o método perde valor.
MTTR (Mean Time To Recover)
MTTR mede o tempo para recuperar a operação após uma falha. Cenários podem ajudar, por exemplo, quando há retorno controlado e orientações claras de recuperação. Mas também podem atrapalhar se as regras de retorno forem conservadoras demais (ou se bloquearem reinício automático sem necessidade). Portanto, métricas devem ser acompanhadas com análise qualitativa das causas.
Ocorrências por tipo de alarme
A contagem de alarmes ajuda a identificar padrões. No entanto, é comum que a adoção de cenários mude a estratégia de alarme (por exemplo, um alarme pode agora encapsular múltiplas causas). Por isso, é essencial padronizar categorização e garantir que comparações “antes e depois” considerem mudanças no modelo de alarmes.
Taxa de execução conforme receita
Essa métrica mede quantas execuções seguem o fluxo esperado e atingem critérios de sucesso, sem desvio fora de tolerância. Um cenário ajuda porque define critérios e validações em etapas. Ainda assim, a taxa pode depender de qualidade de dados e integração (ex.: lote/receita incorreta). Assim, a métrica deve ser interpretada com cuidado.
Durabilidade de comissionamento
Essa métrica busca entender quantas correções ou retrabalhos foram necessários após mudanças. Cenários com requisitos bem definidos tendem a reduzir retrabalho, mas a métrica precisa ser definida com clareza: retrabalho de software? retrabalho de parametrização? retrabalho de hardware? O que conta como “durabilidade baixa”?
Também vale considerar métricas complementares de governança, como:
Essas métricas ajudam a entender se a maturidade do método está crescendo. Se o time está melhorando cenários, mas o ciclo de mudanças está longo, pode haver um gargalo de processo.
Por fim, ao interpretar métricas, evite extrapolações indevidas. Por exemplo, um aumento no MTTR pode estar relacionado a falhas não relacionadas aos cenários (falha mecânica, indisponibilidade de utilidade externa). Por isso, análises devem segmentar por causa e priorizar ações onde cenários realmente fazem diferença.
Scenario Automação é a abordagem de organizar a automação por cenários operacionais (por exemplo, produção, troca, manutenção e falha), definindo gatilhos, condições, sequência e critérios de sucesso para que o sistema se comporte de forma determinística e auditável.
Não. Cenários normalmente orquestram comportamentos sobre a lógica já existente. O controle em tempo real continua sendo executado no nível apropriado (por exemplo, CLP), enquanto a supervisão (por exemplo, SCADA) fornece visibilidade, alarmes e interface operacional.
Com governança de engenharia: catálogo de cenários, padronização de nomenclatura, revisão por pares, controle de versão e matriz de testes vinculada aos requisitos. Sem isso, surgem conflitos de lógica e estados.
Sim. Uma prática eficaz é começar pelos cenários que mais geram variabilidade ou paradas (por exemplo, troca de lote, modo de limpeza, partida após parada). Depois, ampliar gradualmente com base em evidências de teste e ocorrências reais.
Exige documentação mínima com critérios auditáveis. O volume depende da criticidade do processo e de exigências internas/externas. Mesmo assim, o essencial é registrar requisitos, intertravamentos, critérios de sucesso/fracasso e evidências de validação.
Um modo de equilibrar documentação e agilidade é definir níveis de detalhamento. Por exemplo: cenários críticos (afetando segurança/qualidade diretamente) recebem documentação mais extensa; cenários auxiliares podem ter documentação mais compacta, mas ainda precisam ser testáveis e observáveis.
O preço depende do escopo e do nível de integração. Peça proposta com descrição de entregáveis, matriz de cenários, estratégia de testes, custos de comissionamento e responsabilidades. Sem isso, a comparação entre fornecedores fica incompleta.
Quando houver necessidade de rastrear lote/produto, vincular execução a resultados de qualidade e permitir análise posterior (por exemplo, correlação de alarmes com desempenho). Integrações elevam o valor, mas devem ser planejadas para não aumentar complexidade desnecessária.
Na prática, uma boa decisão de integração responde: “sem MES/histórico, conseguimos provar o que ocorreu?” Se a resposta for não, então integração pode ser essencial. Se a resposta for sim, talvez o escopo inicial possa ficar restrito ao que é necessário para operação e diagnóstico.
O valor de Scenario Automação está em transformar operação complexa em comportamentos definidos, testáveis e rastreáveis. Ao estruturar gatilhos, condições, transições e critérios de sucesso, a automação deixa de depender de interpretação humana e passa a responder de forma consistente a eventos reais — incluindo falhas e mudanças de modo. Com governança e validação por cenários, o ganho tende a aparecer não como “promessa”, mas como melhoria demonstrável: mais previsibilidade, diagnósticos mais rápidos e redução de variações operacionais.
Ao aplicar o método, é comum observar uma mudança cultural: em vez de perguntar “o que o sistema faz?”, o time começa a perguntar “qual cenário está ativo, por que ele transicionou e quais critérios foram atingidos”. Essa mudança reduz o custo cognitivo da manutenção e acelera a aprendizagem do processo. O cenário se torna um “vocabulário comum” entre engenharia, operação, manutenção e qualidade.
Se você quiser, posso adaptar este guia ao seu contexto descrevendo: (1) quais cenários você precisa primeiro, (2) uma matriz de testes inicial e (3) um modelo de requisitos para enviar a fornecedores e obter orçamentos comparáveis.



This guide explains how to evaluate SKU 750816 procurement and supplier fit for consistent quality and predictable lead times. Objectively, the keywords relate to identifying a specific item, comparing supplier capabilities, and validating sourcing conditions using documented specifications, commercial terms, and traceable documentation. The focus is practical decision-making grounded in standard supply-chain due diligence.
This guide explains how to approach Fygf with a disciplined sourcing method, focusing on pricing logic and supplier due diligence. Objectively, Fygf is treated here as a procurement-related keyword representing a specific product or service category. Background coverage clarifies how market pricing, lead times, documentation, and quality controls connect—so decisions can be made with confidence.
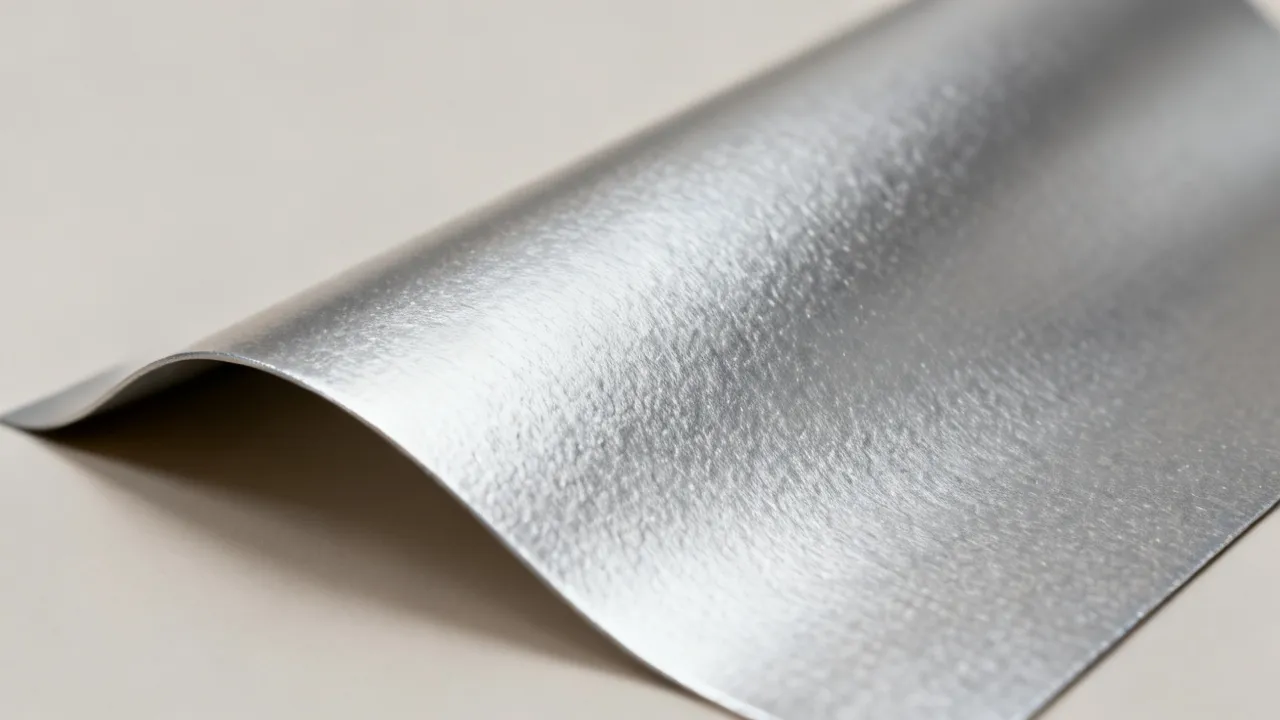
Fulepelata es un material metálico con aplicaciones decorativas e industriales donde importan el acabado, el espesor y la trazabilidad. Este documento explica, de forma objetiva, qué significa el término, por qué se valora en talleres y proyectos, y cómo comparar calidades al solicitar cotizaciones, junto con requisitos habituales de compra, criterios de recepción y preguntas frecuentes para una decisión informada.
Este guia explica, de forma objetiva, como funciona a gestão e organização de informações ligadas ao GSN Contagem, destacando boas práticas, critérios de escolha e cuidados essenciais. Em seguida, contextualiza o termo no ambiente corporativo, discutindo por que empresas utilizam padronização e controles para reduzir riscos operacionais e melhorar a governança.
This guide explains how to evaluate Uu-related pricing and supplier options with a disciplined, risk-aware approach. Objectively, “Uu” functions as a label used across procurement and product catalogs to reference a specific item set or internal code. The article outlines sourcing criteria, supplier validation, and decision conditions for consistent outcomes.
This guide explains how “9i” and related terms—especially “ ”—can be evaluated for smart sourcing decisions, with an objective lens on what to verify before choosing a supplier. It outlines background context, selection criteria, and practical workflows so teams can compare options consistently, manage requirements, and reduce procurement risk while maintaining quality standards.

