Este guia explica como estruturar e implementar automação por cenários, conectando objetivos operacionais, integração de sistemas e governança de dados. Em seguida, apresenta de forma objetiva o contexto dos termos envolvidos, como “Scenario Automação” aplicado a processos industriais e de gestão, com foco em requisitos, etapas de implantação e práticas de verificação para evitar falhas.
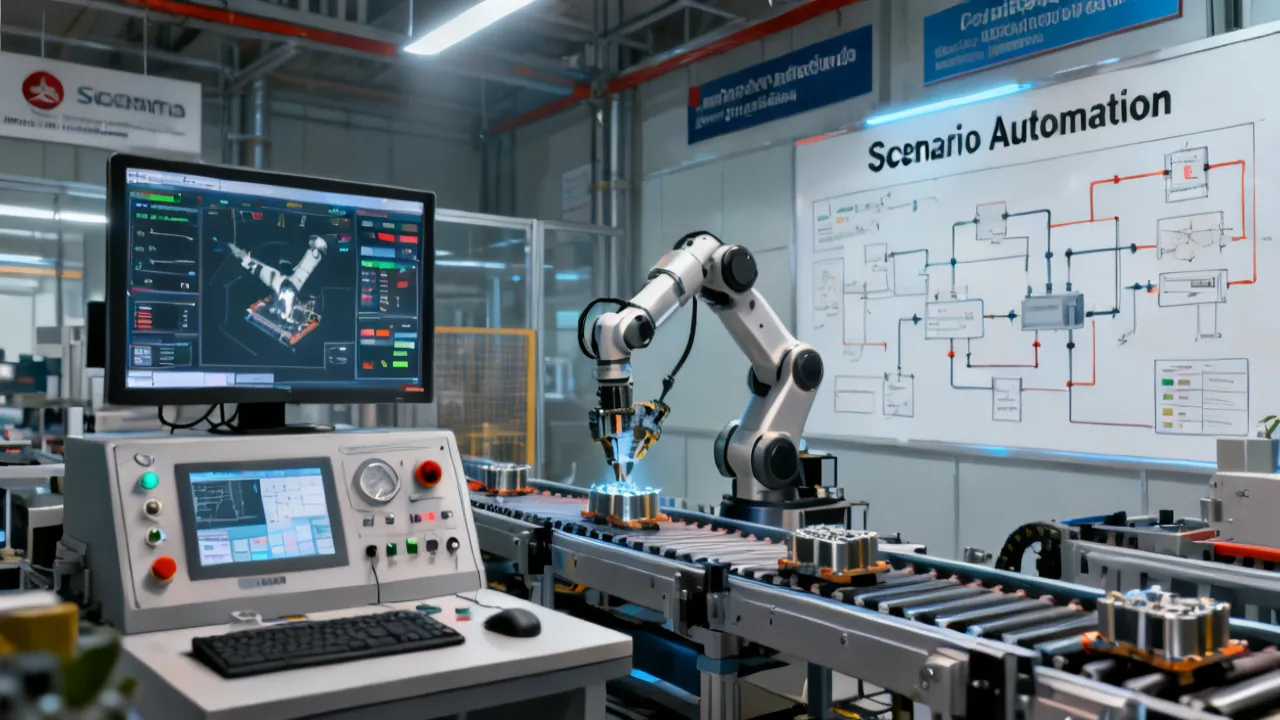
Quando o assunto é Scenario Automação, o valor central está em tratar a operação como um conjunto de “cenários” definidos: condições que disparam fluxos de trabalho, regras de decisão, integrações entre sistemas e critérios de qualidade. Em vez de automatizar apenas tarefas isoladas, a abordagem por cenários busca previsibilidade (o que acontece, quando acontece e por quê), controle (quem aprova, o que é logado e como auditar) e melhor coordenação entre áreas como engenharia, TI e operações.
Do ponto de vista de um especialista, o ponto de partida não é a tecnologia—é a “intenção” do processo. Você traduz metas operacionais em condições objetivas (gatilhos), define respostas (ações) e estabelece salvaguardas (validações, timeouts, trilhas de auditoria). A automação deixa de ser “um roteiro rígido” e passa a ser um orquestrador de comportamento diante de variáveis do mundo real.
Para ganhar previsibilidade de verdade, você precisa aceitar um princípio: sistemas automatizados operam em ambientes imperfeitos. Dados vêm incompletos, eventos chegam fora de ordem, sistemas externos podem atrasar ou falhar, e pessoas frequentemente corrigem “para continuar”. A questão não é se isso vai acontecer—é como o cenário foi desenhado para lidar com isso. Um bom cenário não apenas “faz o que foi pedido”; ele responde de forma consistente ao contexto, preserva evidências e permite correção quando necessário.
Por isso, a aplicação do Scenario Automação normalmente começa por uma mudança de mentalidade: em vez de “automatizar um fluxo”, você “modela decisões”. A modelagem de decisões inclui critérios, limites, exceções, dependências e o que significa terminar “certo”. Assim, o processo vira algo verificável e reexecutável, com rastreabilidade. Essa é a base para previsibilidade operacional: previsibilidade não é ausência de variabilidade, é governança da variabilidade.
Na prática, você organiza cada cenário como uma unidade com:
Quando essas partes estão presentes, você consegue responder perguntas operacionais rapidamente: por que o cenário tomou uma decisão específica, quais dados estavam presentes, se houve desvio e qual impacto teve. Isso reduz tempo de diagnóstico e aumenta a confiança do time no comportamento automatizado.
Em muitos projetos, a equipe começa com fluxos pontuais: um robô coleta dados, uma integração atualiza status, outro módulo envia alertas. Com o tempo, as interdependências aumentam—e o sistema vira um conjunto difícil de depurar. A abordagem baseada em Scenario Automação reduz esse risco ao padronizar:
Uma automação “solta” tende a falhar de forma silenciosa. Mesmo quando existem logs, eles podem estar espalhados e não correlacionar “uma execução” como unidade. Quando ocorrem falhas, o time precisa reconstruir manualmente o caminho: qual integração rodou, qual status foi atualizado primeiro, quais eventos foram descartados e quais entradas estavam inconsistentes. Isso cria o efeito “espaguete operacional”.
Já o cenário, por ser uma unidade autocontida, oferece uma visão coerente. Em vez de perguntar “qual regra/robô travou?”, você pergunta “por que este cenário específico foi executado daquela forma e por que terminou daquele jeito?”. Em geral, essa mudança melhora:
Além disso, cenários favorecem a adoção de práticas de engenharia como testes de regressão com dados reais, simulações e validação de casos de borda. Automação solta costuma depender mais de “ajustes rápidos” e de correções ad hoc. Quando o cenário é a unidade principal, o time consegue medir e controlar qualidade com consistência.
Especialmente em ambientes regulados ou com rastreabilidade exigida, o custo de “descobrir o que ocorreu” costuma superar o custo de projetar cenários desde o início. Mas mesmo onde não há regulação formal, a rastreabilidade é um ativo operacional: aumenta confiança, reduz retrabalho e acelera melhoria contínua.
Um projeto de Scenario Automação bem desenhado normalmente exige três frentes: processos, dados e controle. Essa tríade evita o erro comum de automatizar “o formulário”, mas não o “porquê”. Quando o cenário é orientado por condições, você consegue reproduzir o comportamento com consistência e reduzir o impacto de variações operacionais.
Processos envolvem mapear o fluxo e identificar decisões. Não é suficiente ter um diagrama de atividades; é necessário descobrir onde existem decisões (regras de negócio) e quais estados do processo importam. Muitas falhas ocorrem não por falta de automação, mas por automação aplicada no local errado: ao invés de automatizar o “momento de decisão”, o time automatiza apenas a “ação seguinte”, ficando vulnerável a mudanças de regra ou a variações de dados.
Dados envolvem definir o modelo de informação, qualidade, origem e destino dos eventos. Dados são frequentemente o ponto fraco: campos com semântica ambígua, unidades inconsistentes, ausência de identificadores únicos, ou mudança de schema sem versionamento. Em um cenário, isso é tratado como parte do desenho: se os dados não satisfazem pré-condições, o cenário não deve seguir cegamente; ele deve validar e, quando necessário, interromper e escalar.
Controle envolve governança (papéis, aprovações), logs, auditoria e gestão de versões. Sem controle, a automação pode se tornar um “gerador de efeitos” difícil de revisar. O cenário, portanto, precisa registrar quem executou (automatizado ou humano), qual regra foi aplicada, qual versão do cenário estava ativa e quais dados embasaram a decisão.
Com essa visão sistêmica, o cenário vira uma ponte entre “intenção de negócio” e “execução técnica”. A automação deixa de ser um conjunto de integrações desconectadas e passa a ser um sistema comportamental, capaz de ser observado e governado.
Uma prática recomendada é tratar cada cenário como “contrato de comportamento”: ele especifica como o sistema deve reagir a um conjunto de entradas e condições. Isso reduz o risco de regressão, facilita comunicação entre negócio e TI e torna o processo mais auditável.
Em termos objetivos, um cenário costuma ser definido por gatilhos, pré-condições, regras, ações e pós-condições. Esses elementos parecem básicos, mas a qualidade do desenho depende de quão bem você explicita cada um.
Um cenário, em geral, possui:
Do ponto de vista de engenharia de software e automação industrial, a disciplina está em separar lógica de execução. A lógica define o que deve acontecer; a execução define como e por qual canal. Essa separação permite testar regras sem dependência total de integrações externas e facilita mudança posterior (por exemplo, trocar um sistema de destino sem reescrever a regra).
Para projetar essas condições com qualidade, normalmente você precisa responder perguntas específicas:
Outro ponto crucial é tratar tempo como elemento do cenário. Em operações reais, existe latência esperada, janelas de tempo e risco de timeout. Se um cenário aguarda uma resposta (por exemplo, confirmação de persistência ou confirmação de disponibilidade), ele precisa definir até quando espera, o que faz em caso de atraso e como registra evidências do motivo do timeout.
Também vale considerar o conceito de idempotência no design das pré-condições e no comportamento de ações. Se o mesmo evento chega duas vezes, o cenário deve evitar efeitos duplicados. Isso pode ser alcançado usando identificadores únicos de execução, deduplicação por hash, chaves de idempotência ou registros de estado que impedem reprocessamento indevido.
Por fim, projetar condições não é apenas escrever regras; é garantir que essas regras correspondem ao comportamento desejado pelo negócio. Por isso, é comum envolver áreas funcionais na validação de casos reais e cenários de borda, garantindo que o desenho seja fiel às exceções do dia a dia.
Quando a automação é baseada em cenários, a rastreabilidade deixa de ser um “extra”. Você registra quem iniciou o cenário (ou qual evento iniciou), quais regras foram avaliadas, quais dados estavam disponíveis, qual ação foi executada e com qual resultado, e quais exceções ocorreram e como foram tratadas.
Esse cuidado reduz o risco operacional e o custo de manutenção. Além disso, facilita a resposta a auditorias. Mesmo quando não há exigência regulatória formal, boas trilhas de auditoria aumentam a confiabilidade percebida por times de operação e qualidade.
Um erro comum é tratar auditoria como uma camada “depois”: primeiro constrói o fluxo e, mais tarde, tenta adicionar logs e tags. Em Scenario Automação, a auditoria deve ser parte do design desde o início, pois ela influencia o formato dos dados, o que precisa estar disponível em memória durante a execução e como correlacionar eventos assíncronos.
Para tornar a auditoria efetiva, a execução do cenário deve produzir artefatos rastreáveis. Exemplos de registros que tipicamente devem existir:
Além de registrar, é importante que a auditoria seja legível e investigável. Isso significa que os logs devem ser estruturados (por exemplo, JSON estruturado), que devem existir campos padronizados e que a correlação deve ser possível com uma chave única. Sem isso, você cria um conjunto de logs que “existe”, mas não “ajuda”.
Quando cenários incluem ações humanas (aprovação, conferência, correção manual), a rastreabilidade deve cobrir a participação humana: quem aprovou, qual evidência anexou, qual justificativa foi registrada e como o sistema retomou o fluxo após a intervenção. A previsibilidade operacional depende tanto de entender a lógica automatizada quanto de entender as etapas humanas.
Por fim, conformidade também implica segregação de responsabilidades e controle de mudanças. Se regras mudam, você precisa de versionamento, trilha de aprovação e, em muitos casos, capacidade de rollback. Dessa forma, a auditoria não se limita ao que aconteceu em uma execução; ela também demonstra que as mudanças foram feitas com controle.
A indústria adota diferentes abordagens para materializar Scenario Automação. A escolha depende do ambiente, da maturidade do time e do nível de integração exigido. Entre as formas comuns estão:
Ao comparar abordagens, vale entender as implicações. Em orquestração por regras, você costuma ter uma sequência mais controlada e determinística. Em eventos e mensageria, você precisa lidar com assincronia, duplicidade e ordenação. Em workflows com aprovações, o foco vai para o controle de estados e retorno de execução após decisão humana. Na automação industrial, há exigências mais rígidas de segurança, latência e tolerância a falhas.
Um ponto crucial: quanto mais próximo do “controle físico”, mais rigor precisa existir em segurança, latência e tolerância a falhas. Em automação industrial, cenários podem depender de intertravamentos (interlocks), estados de máquinas, sensores redundantes e validações de segurança. A execução precisa ser previsível em termos de tempo e comportamento. Quando isso não é garantido, o risco operacional aumenta.
Já a automação de processos administrativos, como conciliações e atualizações de status em sistemas corporativos, costuma permitir maior flexibilidade em reprocessamento e reconciliação. Mesmo assim, ainda é necessário idempotência, auditoria e critérios de pós-condição, porque a confiabilidade não depende apenas do ambiente ser “menos físico”. Ela depende da qualidade do desenho do cenário.
Para escolher a abordagem, considere:
Em termos de arquitetura, também é útil pensar em como separar responsabilidades do cenário. Por exemplo, o componente que avalia regras deve ser desacoplado do componente que executa chamadas externas. Assim, a lógica pode ser testada e versionada com menos dependência de sistemas externos.
Finalmente, o motor de cenários deve suportar versionamento e execução observável. Sem isso, você perde a capacidade de evoluir com segurança. Cenários não são “scripts de uma vez”. Eles precisam evoluir com o processo, e essa evolução requer engenharia: testes, validação, rollout controlado e rollback.
Antes de qualquer implementação, você precisa de clareza do desenho. Um especialista começaria com uma definição enxuta, mas completa, de um cenário piloto. Assim, você valida arquitetura, governança e qualidade de dados antes de escalar.
Segue uma sequência recomendada:
Para aprofundar a execução desse passo a passo, há um conjunto de decisões que costuma diferenciar projetos que “funcionam em demo” daqueles que se sustentam em produção.
1) Escolha do cenário piloto. Se o piloto for grande e com muitas exceções ainda desconhecidas, você vai descobrir problemas tarde demais. Pilotos bons têm: volume suficiente para aprender, mas complexidade limitada; relevância para o negócio, mas sem risco alto de efeito irreversível.
2) Mapeamento de decisões. Uma técnica útil é criar uma lista de decisões e perguntas do tipo: “se a condição A for verdadeira e a B for falsa, o que acontece?”. Em seguida, você transforma isso em regras explícitas. Muitas equipes pulam essa etapa e tentam “adivinhar” regras ao implementar o fluxo; é justamente aqui que a abordagem por cenários demonstra valor: você identifica decisões antes de executar.
3) Contratos de dados. Em vez de tratar dados como “passagem de payload”, você transforma os campos em itens com semântica e validação. Campos como “status”, “tipo”, “quantidade” e “timestamp” precisam ter definição clara. É comum incluir validações como consistência de unidades, checagem de formatos, normalização de códigos e validação de valores de enumerações.
4) Observabilidade. Observabilidade é mais do que logs. Inclui métricas de sucesso/fracasso, tempos de execução, distribuição de causas de falha e indicadores que permitem diagnóstico rápido. Além disso, envolve correlação por identificador único. Sem correlação, logs viram “pilhas” e não uma linha do tempo investigável.
5) Tratamento de falhas. Retentativas podem causar efeitos colaterais se a execução não for idempotente. Por isso, o tratamento de falhas deve ser desenhado junto com idempotência e estados persistidos. O cenário deve distinguir falhas transitórias (merecem retry) de falhas permanentes (requerem correção). Um design robusto também considera como limitar loops: por exemplo, não reprocessar indefinidamente quando dados estão inválidos.
6) Testes de borda. Testar só o fluxo feliz não prova confiabilidade. Você precisa de casos que cubram: dados faltantes, valores fora de faixa, duplicidade de eventos, eventos com ordem invertida, e falha de dependências externas (ex.: API indisponível). Esses testes reduzem risco na transição do piloto para produção.
7) Piloto com feedback. Depois do piloto, o cenário deve ser observado em dados reais. Talvez o time descubra que uma pré-condição era restritiva demais, ou que uma regra precisava de ajuste para cobrir um caso que nunca ocorreu em teste. A resposta deve ser controlada: ajustar regras via versionamento e manter histórico de decisões.
8) Escalonamento com versionamento. Ao escalar, você precisa planejar como a nova versão do cenário será ativada. Isso pode envolver rollout gradual, execução em paralelo, feature flags ou migração controlada. O objetivo é reduzir impacto e permitir rollback rápido.
Embora o termo Scenario Automação possa aparecer em diferentes contextos, a lógica por cenários é comum em operações industriais, logística, operações de TI e gestão. Alguns exemplos típicos ajudam a visualizar como cenários se comportam diante de condições.
Exemplo 1: Gestão de incidentes. Quando um alerta chega com severidade X e origem Y, o cenário pode:
Nesse cenário, a previsibilidade vem de decisões explícitas: quais severidades geram automação direta, quais exigem aprovação, e como o cenário reage quando evidências não estão disponíveis.
Exemplo 2: Sequenciamento de produção. Quando um lote atende critérios de qualidade e disponibilidade, o cenário libera o próximo estágio; caso contrário, redireciona para retrabalho ou segregação. Nesse tipo de operação, o cenário pode incluir:
Além disso, o cenário precisa lidar com latência: por exemplo, o status de inspeção pode demorar a chegar. Ele deve definir janelas e rotas de reprocessamento.
Exemplo 3: Conciliação de operações. Quando dois sistemas divergem, o cenário executa reconciliação, registra discrepâncias e solicita validação humana se necessário. Ele pode:
A confiabilidade melhora porque a decisão de “consertar automaticamente” fica associada a critérios claros e rastreáveis.
Exemplo 4: Controle de mudanças e aprovações. Em processos corporativos, você pode ter cenários que disparam aprovações. Por exemplo:
Isso transforma compliance em comportamento automático e auditável.
Exemplo 5: Planejamento de manutenção. Em manutenção preditiva, um cenário pode ser acionado por indicadores de falha (vibração, temperatura, ciclos). Ele pode:
O valor do cenário está em garantir que a automação não seja “cega”: ela valida e escolhe rotas com base em condições e risco.
Em todos esses casos, a automação ganha robustez porque responde a condições específicas—não apenas a “um passo fixo”. É isso que diferencia Scenario Automação de simples automação de fluxo.
Para avaliar um projeto de Scenario Automação, o foco deve recair em confiabilidade e governança, não somente em “velocidade”. Indicadores úteis incluem taxa de sucesso, tempo de ciclo, taxa de exceções e desempenho de tratamento de falhas.
Entre as métricas mais relevantes:
Além dessas, há métricas que ajudam a manter previsibilidade:
Ao escolher métricas, recomenda-se alinhar com relatórios consolidados e padrões reconhecidos. Por exemplo, práticas de gerenciamento de serviços e automação orientadas por observabilidade podem ser referenciadas em materiais amplamente adotados em IT Service Management (ex.: ITIL) e em princípios de engenharia de confiabilidade e observabilidade. Contudo, a definição final deve refletir seu contexto e requisitos.
Uma boa prática é estabelecer uma linha de base (baseline) do processo anterior ao piloto. Compare:
Ao medir, evite métricas que incentivem comportamento indesejado. Por exemplo, medir apenas “quantidade de execuções concluídas” pode induzir a reduzir validações para não escalar erros. Em Scenario Automação, é essencial medir qualidade do resultado e a correta aplicação de regras e pós-condições.
Por fim, as métricas devem ser usadas para melhoria contínua. Se a taxa de exceções está alta, você deve analisar causas: dados mal formatados, gatilhos inadequados, pré-condições restritivas, integrações instáveis ou regras incompletas. O cenário vira um produto de engenharia que evolui com dados do mundo real.
A seguir, apresento uma comparação objetiva com cenário como unidade de automação e os pontos operacionais que normalmente precisam estar “prontos” antes de escalar. Esta seção serve como guia suplementar, com condições e requisitos aplicados ao projeto.
| Elemento | O que verificar | Condição/forma de aceitação |
|---|---|---|
| Fonte de dados (eventos/inputs) | Origem dos eventos, qualidade mínima, idempotência e tempo de chegada | Dados com campos obrigatórios; tratamento de duplicidade definido; latência dentro do esperado para o cenário |
| Motor/Orquestração | Como as regras são avaliadas e como as ações são disparadas | Execução determinística para o mesmo conjunto de pré-condições; versionamento de regras suportado |
| Observabilidade | Logs por execução, correlação por identificador, trilha de auditoria e alertas | Qualquer execução pode ser rastreada do gatilho à pós-condição; logs suficientes para diagnóstico |
| Regras de decisão | Critérios claros, tratamento de bordas e exceções | Casos de borda mapeados; testes cobrindo variações reais do processo |
| Tratamento de falhas | Retentativas com limites, timeouts, filas e rotas de escalonamento | Falhas transitórias não causam loops; falhas permanentes são escaladas com evidências |
| Segurança e permissões | Controle de acesso por função e segregação de responsabilidades | Ações sensíveis exigem aprovação; credenciais protegidas; princípio do menor privilégio |
| Validação pós-execução | Checagens de integridade e confirmação de persistência | Pós-condições confirmadas; divergências registradas e acionam rota de correção |
Fontes e base conceitual (referências não exaustivas): recomenda-se alinhar a implementação com boas práticas de governança e confiabilidade operacional, como diretrizes amplamente adotadas em IT Service Management (ex.: ITIL) e princípios de engenharia de confiabilidade e observabilidade. Para fundamentos de mensageria e idempotência em sistemas orientados a eventos, conceitos de arquitetura de software e padrões de engenharia costumam ser descritos em documentação técnica de referência e literatura acadêmica. Em projetos corporativos, a validação final deve ser feita com políticas internas, requisitos de auditoria e diretrizes de segurança.
Como complemento, ao avaliar a prontidão para escala, muitas equipes também criam “critérios de entrada” e “critérios de saída” para cada cenário. Critérios de entrada definem o que precisa estar garantido para o cenário rodar com segurança (por exemplo, dados mínimos e disponibilidade de dependências). Critérios de saída definem o que precisa ocorrer para o cenário ser considerado bem-sucedido (pós-condições e integridade).
Essa abordagem reduz a subjetividade: em vez de “parece que funcionou”, você passa a “cumpriu requisitos” e “passou em critérios”. Com o tempo, isso aumenta qualidade e diminui risco de regressão.
Na prática, Scenario Automação refere-se a estruturar a automação a partir de cenários: condições que disparam regras e fluxos de ações, com validações, exceções e rastreabilidade. O objetivo é que a automação se comporte de modo previsível diante de variações do processo.
Uma forma simples de compreender é pensar em “um cenário” como uma unidade de comportamento: quando certas entradas e condições existem, o sistema decide um caminho e executa ações com validação e logs. Se o contexto muda (dados inválidos, disponibilidade diferente, regras alteradas), o cenário não “quebra”; ele age conforme sua lógica definida.
Não existe um “percentual universal”. O recomendado é começar com um cenário piloto, de escopo controlado, que traga valor e permita aprender sobre dados, regras e exceções. A expansão ocorre quando a confiabilidade, a governança e a observabilidade atingem critérios definidos.
Em geral, é melhor automatizar com qualidade um subconjunto bem escolhido do processo do que automatizar parcialmente tudo e não conseguir explicar decisões. Cenários bem projetados permitem expansão mais segura, porque a unidade de execução permanece auditável.
Defina pré-condições e regras de validação. Para duplicidade, aplique idempotência (mesmo efeito para o mesmo identificador/execução) e mantenha controle de reprocessamento. Registre discrepâncias e, quando necessário, acione rotas de correção com evidências para intervenção humana.
Na prática, você pode tratar incompletude com duas estratégias: (1) parar e escalar quando dados mínimos não existem; (2) seguir por caminhos alternativos quando a ausência não compromete decisão (por exemplo, usando valores padrão quando permitido). A escolha depende do risco. Para duplicidade, além de idempotência, um cenário pode usar estado persistido para reconhecer execuções anteriores e evitar efeitos repetidos.
Depende do risco e do nível de criticidade. Em rotas de alto impacto (ex.: alterações irreversíveis, decisões reguladas), aprovações e segregação de responsabilidades costumam ser parte do desenho. Em operações de baixo risco, a automação pode ser mais direta, desde que exista observabilidade e validação pós-execução.
Uma prática comum é adotar “aprovação por exceção”: a execução automática roda na maior parte das vezes, mas quando certas condições de risco são atingidas (ou quando validações falham), o cenário exige intervenção humana. Isso equilibra eficiência e controle.
Use métricas orientadas a confiabilidade e desempenho do ciclo: taxa de sucesso, tempo de execução, taxa de exceções, frequência de reprocessamento e tempo para diagnóstico/correção. Compare com a linha de base do processo atual e valide com dados reais do piloto.
Além de métricas de execução, avalie a qualidade do diagnóstico: se o time consegue identificar rapidamente por que um cenário tomou uma decisão específica, isso é um indicador indireto de que observabilidade e rastreabilidade estão bem desenhadas.
Em geral, cenários orquestram e integram sistemas, em vez de substituí-los. O ganho vem de padronizar regras, contratos de dados e tratamento de exceções entre componentes. A arquitetura final depende do que já existe e do nível de integração possível.
Por exemplo, um cenário pode usar o ERP como fonte de dados e destino de persistência, enquanto um MES pode prover eventos de estado de produção. O valor do cenário é coordenar decisões e manter consistência de comportamento entre sistemas.
Normalmente é necessário: entendimento claro do processo-alvo, disponibilidade de dados (ou capacidade de gerar eventos com consistência), definição de regras de decisão e um mecanismo de rastreio/logs por execução. Sem isso, a iteração fica sujeita a “achismo” e dificulta a validação.
Um requisito adicional que costuma separar fracasso de sucesso é o compromisso com governança: alguém precisa ser responsável por aprovar regras, validar critérios e aceitar mudanças com versionamento. Sem isso, o cenário vira um “projeto infinito” sem critérios claros de pronto.
Ao tratar Scenario Automação como um método—e não apenas como uma ferramenta—você constrói uma automação mais sustentável, com governança, rastreabilidade e respostas robustas a exceções. A essência está em projetar condições, decisões, contratos de dados e observabilidade desde o início. Com um piloto bem definido e critérios de aceitação claros, a evolução deixa de ser improviso e passa a ser engenharia de processo, orientada por evidências.
Se o seu objetivo é aumentar eficiência sem perder controle, comece pequeno, documente regras, teste casos de borda e escale apenas quando o comportamento em produção for previsível. Esse é o caminho mais seguro para transformar automação em confiabilidade operacional.
Quando a empresa adota cenários como unidade de trabalho, ela ganha mais do que automação: ganha disciplina. Disciplina para medir, para auditar, para gerir versões e para tomar decisões com evidências. É essa disciplina que sustenta a automação ao longo do tempo, mesmo quando o processo muda, os sistemas evoluem e novas exceções surgem no mundo real.



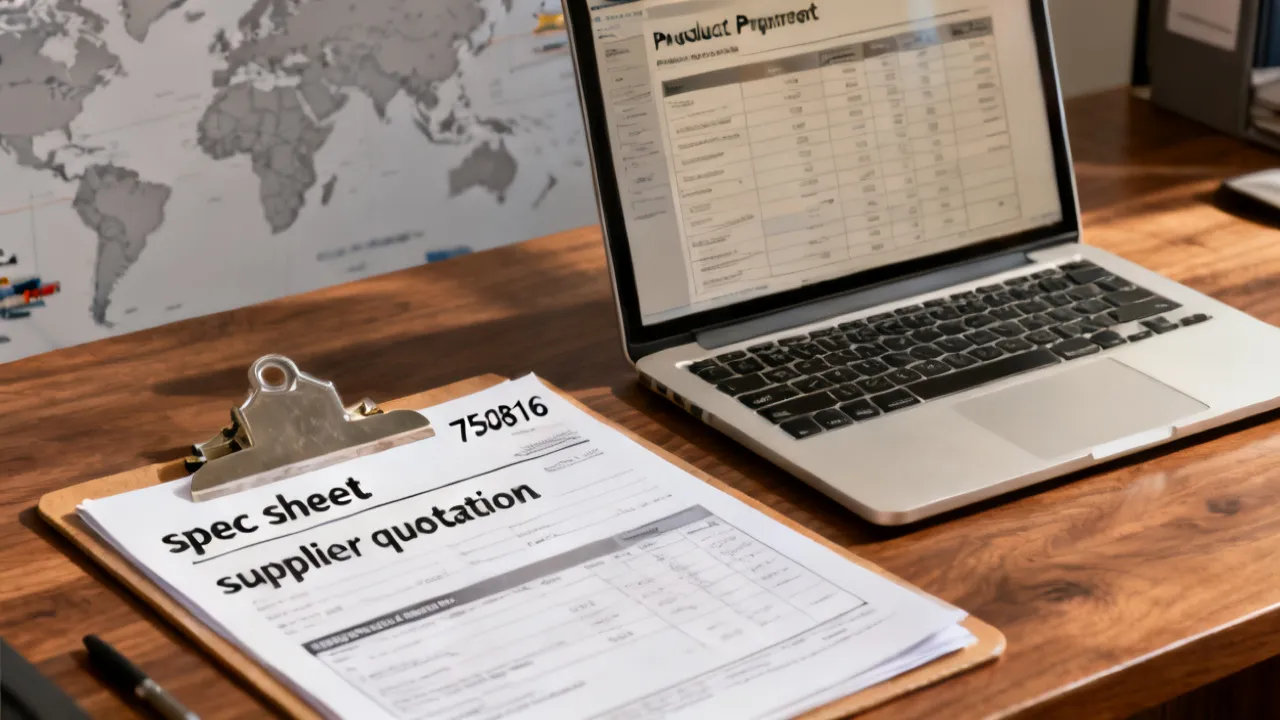
This guide explains how to evaluate SKU 750816 procurement and supplier fit for consistent quality and predictable lead times. Objectively, the keywords relate to identifying a specific item, comparing supplier capabilities, and validating sourcing conditions using documented specifications, commercial terms, and traceable documentation. The focus is practical decision-making grounded in standard supply-chain due diligence.
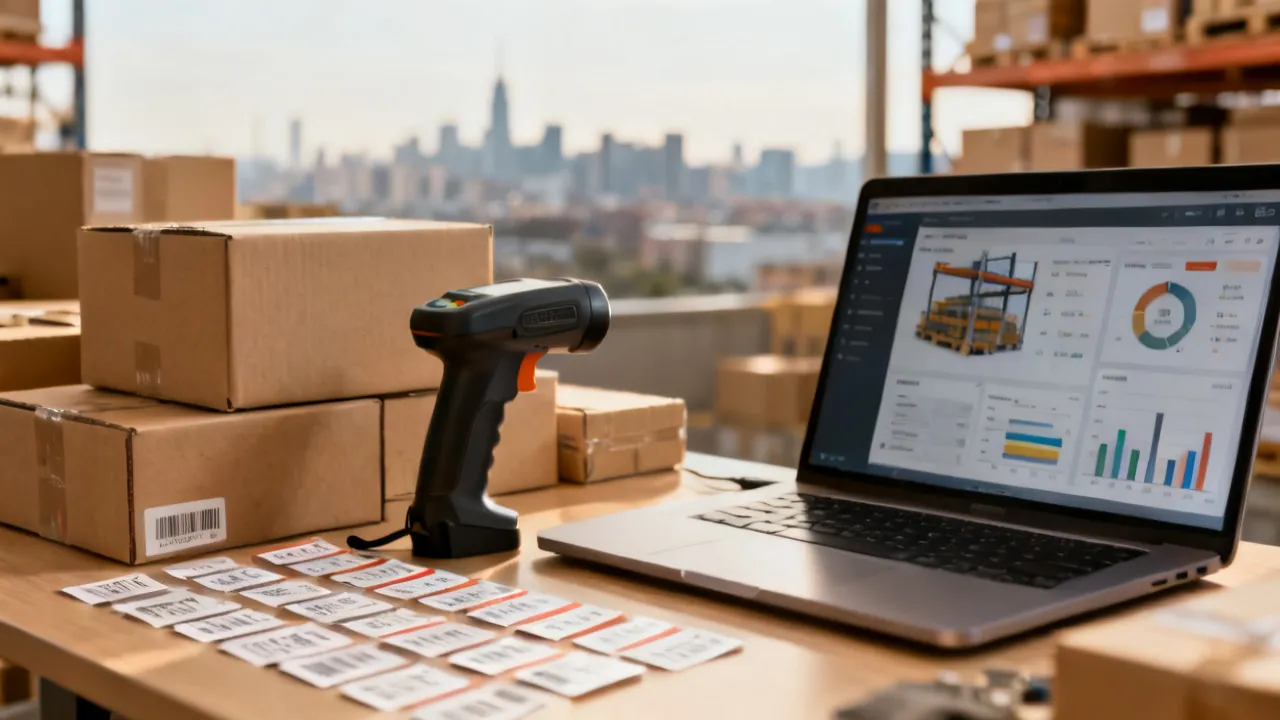
This guide explains how to approach Fygf with a disciplined sourcing method, focusing on pricing logic and supplier due diligence. Objectively, Fygf is treated here as a procurement-related keyword representing a specific product or service category. Background coverage clarifies how market pricing, lead times, documentation, and quality controls connect—so decisions can be made with confidence.
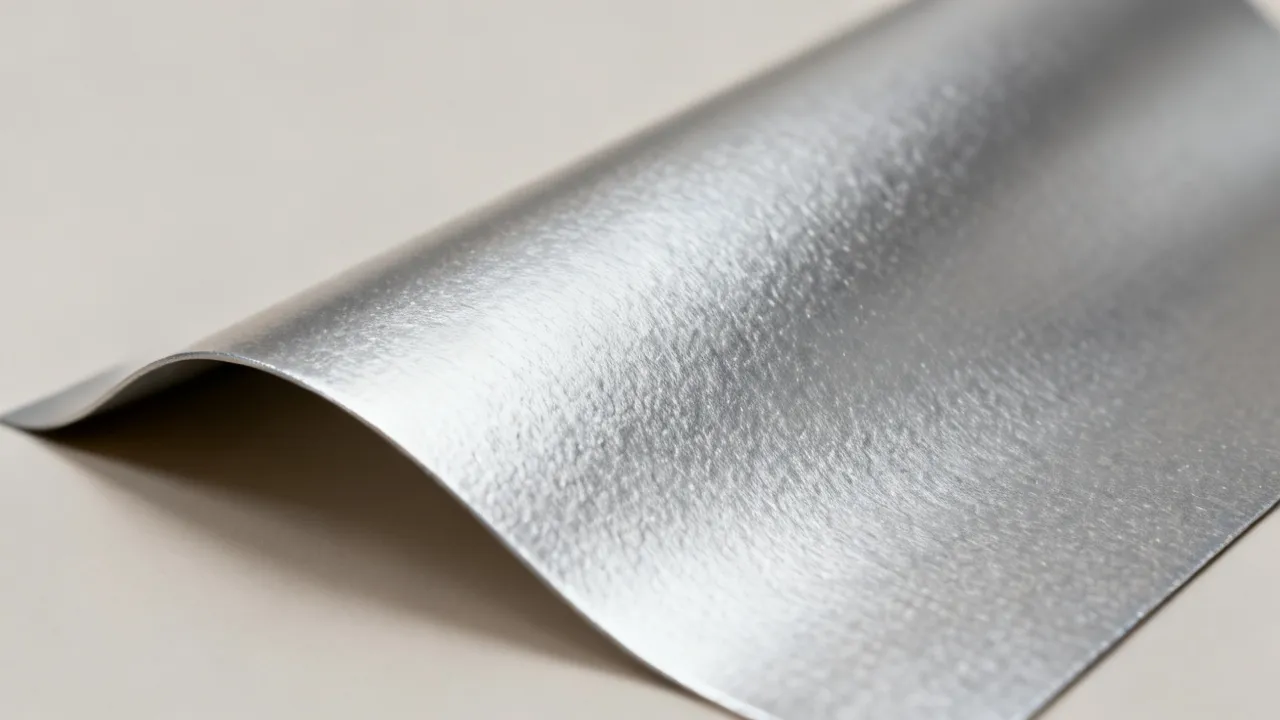
Fulepelata es un material metálico con aplicaciones decorativas e industriales donde importan el acabado, el espesor y la trazabilidad. Este documento explica, de forma objetiva, qué significa el término, por qué se valora en talleres y proyectos, y cómo comparar calidades al solicitar cotizaciones, junto con requisitos habituales de compra, criterios de recepción y preguntas frecuentes para una decisión informada.
Este guia explica, de forma objetiva, como funciona a gestão e organização de informações ligadas ao GSN Contagem, destacando boas práticas, critérios de escolha e cuidados essenciais. Em seguida, contextualiza o termo no ambiente corporativo, discutindo por que empresas utilizam padronização e controles para reduzir riscos operacionais e melhorar a governança.
This guide explains how to evaluate Uu-related pricing and supplier options with a disciplined, risk-aware approach. Objectively, “Uu” functions as a label used across procurement and product catalogs to reference a specific item set or internal code. The article outlines sourcing criteria, supplier validation, and decision conditions for consistent outcomes.
This guide explains how “9i” and related terms—especially “ ”—can be evaluated for smart sourcing decisions, with an objective lens on what to verify before choosing a supplier. It outlines background context, selection criteria, and practical workflows so teams can compare options consistently, manage requirements, and reduce procurement risk while maintaining quality standards.

