A Automação Dicionario organiza definições, regras e mapeamentos para acelerar integrações e reduzir ambiguidades operacionais. O texto contextualiza, de forma objetiva, o que é um dicionário de automação, como ele apoia padronização de dados e decisões, e quais requisitos organizacionais favorecem a adoção em ambientes de TI e negócios.
A Automação Dicionario é uma abordagem de padronização que transforma termos, campos e intenções de negócio em regras e mapeamentos reutilizáveis. Em termos práticos, ela ajuda a conectar sistemas, normalizar dados e orientar ações automatizadas com menor risco de interpretações divergentes. Para empresas que precisam integrar múltiplas fontes (ERP, CRM, planilhas, APIs, integrações legadas), esse “dicionário” funciona como uma camada de consistência: define como cada conceito deve ser entendido, quando deve ser usado e como deve se relacionar a outras entidades.
Do ponto de vista de governança e engenharia de processos, o valor central está em previsibilidade: quando o significado de “um cliente”, “uma solicitação” ou “um status” está claramente descrito e versionado, a automação tende a ficar mais estável ao longo do tempo. Isso se reflete em menor retrabalho, menos exceções manuais e maior capacidade de auditoria—sem exigir que equipes reescrevam lógica sempre que o negócio evolui.
É comum que organizações enxerguem automações como “rotinas” (scripts, jobs e fluxos) e não como “produtos de decisão”. A Automação Dicionario muda esse enquadramento: ela trata a semântica e as regras como ativos reutilizáveis. Assim, em vez de cada fluxo criar seu próprio entendimento de termos (criando micro-interpretadores), o entendimento passa a ser único, controlado e compartilhado. Isso reduz drasticamente a divergência entre times e sistemas, especialmente quando há crescimento do volume, aumento do número de integrações e maior diversidade de canais de entrada (por e-mail, portal, atendimento, EDI, WhatsApp, formulários e importações).
Além disso, a Automação Dicionario acelera processos por dois caminhos simultâneos: (1) reduz o tempo de triagem e decisão ao aplicar regras consistentes automaticamente, e (2) reduz o tempo de correção quando ocorre discrepância, porque a rastreabilidade das regras facilita detectar onde o entendimento divergiu (no dicionário, no mapeamento ou na entrada).
Em empresas brasileiras, é frequente que o mesmo termo circule com nuances diferentes entre áreas—por exemplo, “urgente” em uma operação pode significar “prazo curto”, enquanto em uma área comercial significa “alta prioridade de receita”. Quando esse tipo de ambiguidade entra na automação, surgem falhas difíceis de diagnosticar: o sistema “faz certo”, porém com o significado “errado” do negócio. A Automação Dicionario combate esse problema atacando diretamente o ponto onde a ambiguidade nasce: o significado.
Embora existam implementações com nomes e formatos variados, uma “Automação Dicionario” costuma incluir os seguintes elementos:
Quando esses componentes estão bem desenhados, a automação passa de um conjunto de rotinas frágeis para um ecossistema de definições compartilhadas. Esse salto costuma ser o que diferencia iniciativas pontuais de automação de um programa mais sólido de melhoria contínua.
Vale observar que a Automação Dicionario não é apenas “uma tabela de mapeamento”. Em projetos maduros, ela tende a ter camadas. Uma camada descreve o conceito (por exemplo, “Cliente Ativo”), outra descreve critérios de inferência (por exemplo, quais condições definem “ativo”), outra descreve transformações (por exemplo, como normalizar CPF, CNPJ e nomes), e outra descreve decisões (por exemplo, como essas definições determinam tratamento e roteamento). Essa separação ajuda a evoluir sem gerar efeitos colaterais.
Um design típico também inclui mecanismos para:
Sem esses mecanismos, o dicionário pode até padronizar alguns valores, mas não “dirige” com confiabilidade o que a automação deve fazer em todos os cenários. A qualidade do dicionário, portanto, é medida tanto pela exatidão nos casos comuns quanto pela robustez nos casos extremos.
Em projetos de integração, uma das causas mais comuns de falhas não é a tecnologia em si, mas sim a falta de alinhamento semântico. Dois times podem usar os mesmos termos, porém com significados diferentes; ou então sistemas podem gravar valores com formatos incompatíveis. A Automação Dicionario atua como “contrato de entendimento” entre:
Com essa camada, a automação tende a se comportar de forma mais uniforme, especialmente em cenários de crescimento—quando novas integrações entram e novas exceções começam a aparecer.
Um ponto crítico aqui é que “integração” quase nunca é só um fluxo de dados. Integração é também:
Quando essas dimensões não estão “contratadas”, a automação fica dependente de “conhecimento tribal”. Isso significa que alguém sabe que “quando vem do e-mail X, é sempre do tipo Y”, mas esse conhecimento não está formalizado. A Automação Dicionario transforma conhecimento tribal em regra explícita, com governança e rastreabilidade.
Na prática, esse contrato semântico reduz inconsistências como:
Ao formalizar essas dimensões, a Automação Dicionario acelera não apenas o “processo automatizado”, mas também o “processo de mudança”. Alterar um significado passa a ser uma mudança controlada no dicionário, com impacto claro, testes e rollback planejado—em vez de uma caça manual por fluxos e scripts que podem estar interpretando o termo de forma diferente.
Ao implementar uma abordagem de Automação Dicionario, organizações frequentemente buscam:
Esses benefícios não são automáticos; dependem de desenho correto, disciplina de versionamento e participação do negócio. Ainda assim, a literatura de boas práticas em gestão de dados e governança reforça que padronizações e contratos semânticos são determinantes para estabilidade de integrações.
Para evitar “promessas exageradas”, vale discutir em termos operacionais o que muda quando a automação se apoia no dicionário. Em geral:
Esse último ponto é particularmente relevante em ambientes regulados ou com exigências de auditoria. Se uma decisão automatizada impacta faturamento, crédito, conformidade, prazos contratuais ou escalonamento de atendimento, a capacidade de demonstrar “por que o sistema fez X” é um diferencial.
O termo “dicionário” pode remeter a diferentes conceitos. Em muitos contextos, ele se aproxima de um dicionário de dados ou de uma camada semântica. Em governança, a ideia de “definições compartilhadas” aparece com frequência ao tratar de:
O diferencial da Automação Dicionario é que, além de documentar, ela orienta ações. Ou seja, as definições não ficam apenas em documentação; elas influenciam rotinas automatizadas, mapeamentos e decisões.
Em projetos que seguem abordagens semânticas mais formais, há semelhanças com ontologias: um conceito pode ter atributos e relações; e diferentes entidades podem se relacionar via regras. Contudo, a Automação Dicionario normalmente é pragmática: o objetivo é que a semântica seja executável e operacional.
Uma forma de visualizar a diferença:
Mesmo quando não se usa o termo ontologia, é comum que equipes acabem criando estruturas parecidas com “taxonomias executáveis”. Por exemplo, uma taxonomia de motivos de contato pode ter regras de roteamento e critérios de SLA. A Automação Dicionario garante que essas taxonomias não fiquem “presas” apenas em uma planilha ou em uma planilha que alguém mantém manualmente sem versionamento.
Na prática, esse tipo de abordagem é útil em rotinas onde há muita variação de entrada e necessidade de padronização de saída. Exemplos:
Em linguagem coloquial de operação (como se ouve no dia a dia de muitas empresas brasileiras), o objetivo é “parar de discutir significado a cada ocorrência”. Quando o dicionário está correto e atualizado, a conversa muda: em vez de debater “o que quer dizer”, a equipe discute “qual regra deve ser aplicada”. Isso muda até o estilo das reuniões: menos linguajar interpretativo, mais discussão de critério e cobertura de casos.
Vamos aprofundar alguns cenários práticos para tornar o conceito mais concreto.
1) Triagem de solicitações (SAC/Help Desk)
Imagine que mensagens chegam por e-mail, portal e formulário. O texto pode conter variações (“segunda via”, “boleto”, “2ª via do boleto”, “comprovante”, “atualização cadastral”). A Automação Dicionario pode estabelecer:
Em vez de cada automação ter seu próprio classificador e sua própria lógica de prioridade, o dicionário centraliza a semântica. Assim, quando o negócio decide criar um novo tipo (por exemplo, “contestação”), basta estender o vocabulário e criar regras relacionadas; as automações que consultam o dicionário passam a ter o novo comportamento sem reescrever tudo.
2) Integração CRM ↔ ERP
Em integrações comerciais, o “status do cliente” ou “fase do lead” pode ser representado por códigos diferentes nos sistemas. Além disso, há divergência sobre o que significa “ativo”, “inativo”, “qualificado”, “em negociação”. A Automação Dicionario pode definir:
Esse tipo de integração normalmente sofre quando surge um novo estado em um sistema. Por exemplo: o ERP adiciona o estado “suspenso temporariamente”. Se o dicionário não estiver preparado, o fluxo pode tratar como “inativo” indevidamente. Com a Automação Dicionario, a mudança se traduz como atualização do vocabulário, mapeamento e decisão; e as rotinas conseguem lidar com a nova categoria com comportamento definido.
3) Normalização de cadastros
Cadastros são notoriamente inconsistentes. Canais e tipos de contato podem vir com variações (“cel”, “telefone celular”, “(11) 99999-9999”). Endereços podem conter campos diferentes, e documentos podem ser digitados com formatações distintas. Um dicionário executável pode embutir:
Ao fazer isso, a automação deixa de depender de “limpeza manual” antes do processo. E quando a limpeza muda (por exemplo, decide-se aceitar um formato adicional de telefone), a regra central é atualizada e propagada.
4) Orquestração de workflows e redução de exceções
Workflows sofrem quando as condições não são uniformes. Suponha um fluxo que abre um ticket e define SLA baseado em “prioridade”. Se cada fluxo interpreta “prioridade alta” de forma diferente, a fila recebe casos fora do padrão. Com um dicionário, a prioridade é derivada de critérios explícitos, evitando exceções recorrentes.
Nesse cenário, a automação “pára de quebrar” em pontos previsíveis porque a semântica foi unificada. Além disso, quando uma exceção aparece, ela vira um caso para atualização do dicionário, e não apenas uma correção manual permanente.
Um especialista em arquitetura e gestão de processos costuma avaliar a Automação Dicionario em quatro dimensões: semântica, engenharia, governança e uso. Abaixo estão os critérios típicos.
Defina com clareza conceitos e relações. Evite definições vagas (“prioridade alta” sem critério). O dicionário deve responder: quais entradas levam a quais interpretações e saídas?
Padronize formatos, crie mecanismos de validação e estabeleça “rotas” entre conceitos. Pense também em performance e manutenção.
Se o negócio não valida, o dicionário tende a virar uma coleção de regras “soltas”. Defina aprovação, versionamento e comunicação de mudanças.
O dicionário precisa ser adotado por quem cria/ajusta automações. Se cada time contornar o padrão, você perde consistência.
Vamos aprofundar cada dimensão com exemplos e “armadilhas” comuns.
Semântica: o risco de “definição bonita, regra fraca”
Uma armadilha frequente é criar descrições textuais que parecem corretas, mas não possuem critérios operacionais. Por exemplo: “Cliente VIP é aquele que tem bom relacionamento”. Isso é ambíguo e não executável. Em vez disso, a definição precisa ser transformada em critérios: “Cliente VIP = RFM score acima de X, contrato ativo e faturamento acumulado acima de Y nos últimos Z dias”. Se a organização não tem dados para esses critérios, a definição vira uma declaração incompleta.
Outro risco é confundir termos iguais em sistemas diferentes. “Status do lead” no CRM pode ter “Em contato”, enquanto no ERP pode ter “Em análise”. O dicionário deve explicitar o mapeamento e a correspondência semântica. Se não houver equivalência real, o fluxo deve tratar como exceção e não como equivalência falsa.
Engenharia: o dicionário executável precisa ser resiliente
Do ponto de vista técnico, o dicionário deve ser consultável por automações com consistência de versão. Isso envolve:
Sem essas características, o dicionário pode até existir, mas as automações continuam frágeis, porque não sabem o que fazer quando o dicionário retorna “não aplicável” ou “regra inexistente”. Uma solução boa trata esse “gap” explicitamente.
Governança: versão é proteção
Quando o significado muda e ninguém sabe, o sistema pode “quebrar silenciosamente”. Por isso, governança deve definir:
Governança também deve determinar o que é “mudança grande” (que exige aprovação mais rigorosa) versus “mudança pequena” (que não altera significado central, apenas amplia cobertura). Sem essa política, o processo de mudança vira caos.
Adesão: padronização sem adesão é decoração
O dicionário só produz valor quando é consultado pelas automações. Isso requer:
Em organizações com múltiplas áreas, às vezes existe resistência: o time prefere “rápido e local”. Mas, com o tempo, o custo de manter variações costuma superar o ganho inicial. A Automação Dicionario funciona como uma “infra de decisão” que organiza e reduz custos cumulativos.
Você mencionou “price information” e detalhes de fornecedores, porém nenhuma informação numérica ou dados de fornecedor foram fornecidos. Para manter a análise responsável, este artigo descreve como estruturar custos e o que normalmente entra em orçamento de uma iniciativa de Automação Dicionario, sem inventar valores.
Em geral, o custo é composto por:
Se você tiver preço, fornecedor e localidade específicos, posso reorganizar esta seção com números e comparações diretas. Por ora, o foco é orientar o planejamento com critérios verificáveis.
Para ampliar essa visão de forma prática, vale detalhar como custos costumam aparecer no ciclo de vida:
1) Custos iniciais (setup)
2) Custos de implantação (incrementos)
3) Custos contínuos (operação e evolução)
Um erro comum em orçamentos é assumir que haverá apenas “um projeto” e que depois o dicionário ficará estático. Na prática, o dicionário é um produto em evolução. O custo recorrente precisa ser planejado, inclusive para que exista uma equipe responsável por resolver solicitações de mudança.
| Fase | Objetivo | Entregável típico | Requisitos/Condições |
|---|---|---|---|
| 1. Diagnóstico semântico | Mapear termos e onde eles “quebram” entre sistemas | Lista de conceitos + exemplos reais de entradas/saídas | Disponibilidade de amostras e acesso a processos reais |
| 2. Modelagem do dicionário | Definir estrutura, campos e relações | Modelo de dados conceitual e regras iniciais | Alinhamento com TI e negócio; definição de “fonte de verdade” |
| 3. Regras de transformação e validação | Normalizar entradas e padronizar decisões | Conjunto de regras + critérios de validação | Critérios mensuráveis; testes com dados históricos |
| 4. Integração com automações | Acoplar o dicionário aos workflows | Fluxos atualizados e pontos de consulta ao dicionário | Arquitetura que permita versionamento e rollback |
| 5. Governança e ciclo de mudança | Garantir manutenção contínua e segurança operacional | Processo de aprovação + trilha de auditoria | Responsáveis definidos (RACI) e política de versões |
| 6. Adoção e melhoria contínua | Reduzir exceções e expandir cobertura | Backlog de melhorias + métricas de consistência | Rotina de revisão periódica com usuários-chave |
Para tornar esse guia realmente utilizável, é interessante complementar cada fase com “sinais de prontidão” (quando você sabe que pode seguir) e “erros comuns” (quando você sabe que está prestes a sofrer).
Fase 1: Diagnóstico semântico
Fase 2: Modelagem do dicionário
Fase 3: Regras de transformação e validação
Fase 4: Integração com automações
Fase 5: Governança e ciclo de mudança
Fase 6: Adoção e melhoria contínua
Sem requisitos mínimos, a “Automação Dicionario” pode virar apenas um documento ou um repositório estático. Para evitar isso, considere:
Podemos transformar essas condições em um checklist operacional. Por exemplo:
Essas condições parecem óbvias, mas em muitos projetos são omitidas. O resultado é que o dicionário “existe”, mas não sustenta automações com confiabilidade. Em ambientes de alta criticidade, isso pode gerar incidentes repetitivos, porque o sistema “faz novamente a mesma coisa errada” em vez de aprender e evoluir.
Não necessariamente. Um dicionário de dados geralmente descreve conceitos e estruturas. A Automação Dicionario incorpora a aplicação prática: regras e mapeamentos que influenciam decisões e rotinas automatizadas.
Uma forma útil de entender é pensar em camadas: o dicionário de dados é o “mapa”; a Automação Dicionario é o “motor de decisão” que roda sobre esse mapa. Ambos podem usar vocabulários semelhantes, mas a Automação Dicionario foca em executabilidade e governança para o uso em automações.
Em muitos casos, ele complementa integrações. A ideia é reduzir interpretação errada e padronizar campos, podendo melhorar automações sem necessariamente substituir todos os sistemas.
Em geral, a adoção começa por onde há maior divergência. Por exemplo, se o maior retrabalho ocorre na triagem de solicitações, o dicionário primeiro atende a classificação e roteamento. Depois ele expande para sincronização de status e normalização de cadastros. Essa abordagem incremental costuma reduzir risco e acelerar valor.
Normalmente, impacta times de TI (integrações e automações), operação (triagem e rotinas), dados/analytics (consistência semântica) e negócio (aprovação de regras).
Vale destacar que a área de qualidade de dados e governança também tende a participar, pois o dicionário pode incluir validações e normalizações. Assim, a melhoria se estende para além da automação, elevando o padrão de dados consumidos por analytics e relatórios.
Uma boa prática é criar critérios de classificação e registrar exemplos reais. Para termos voláteis, use versionamento, janelas de transição e documentação clara do que muda entre versões.
Além disso, termos voláteis geralmente exigem uma estratégia de “nível de certeza”. Por exemplo, uma regra pode classificar com alta confiança e outra com baixa confiança. Quando a confiança é baixa, o fluxo encaminha para exceção (humano) e registra evidência para revisão. Isso impede que ambiguidade vire automação errada.
Existe risco se o dicionário for rígido e não tiver governança. Quando bem implementado, ele permite evolução controlada: mudanças são aprovadas e testadas antes de impactar automações em produção.
Para equilibrar rigidez e flexibilidade, uma prática comum é categorizar mudanças. Mudanças que alteram significado (semântica) seguem um processo mais rigoroso. Mudanças que apenas ampliam cobertura (novas palavras para a mesma categoria, ou novas entradas que se encaixam na definição existente) podem seguir um fluxo mais rápido, desde que haja testes.
Você pode acompanhar indicadores como redução de exceções, consistência de classificações, taxa de retrabalho e tempo de resolução. Para métricas robustas, alinhe definição e coleta de dados com antecedência.
Algumas métricas complementares que costumam ajudar:
Na prática, precisa haver um referencial principal (“fonte de verdade”). Pode haver estruturas distribuídas, mas as definições críticas devem convergir para um ponto de governança.
Em arquiteturas mais complexas, a centralização pode ser lógica: diferentes serviços consultam o mesmo repositório de dicionário, garantindo consistência. Isso facilita auditoria e evita que cada time crie “seu próprio dicionário”.
Consistência de formato, capacidade de versionar regras, validações automatizadas e mecanismos de observabilidade. O desenho depende da arquitetura do ambiente e das integrações utilizadas.
Também é comum que o dicionário precise de interfaces estáveis (APIs internas) para consumo por fluxos. Assim, o consumo não fica “acoplado” a formatos internos que podem mudar com o tempo.
Ajuda quando inclui validações e normalizações que impedem entradas inconsistentes de chegarem a decisões automatizadas. Ele atua como filtro de semântica e regra.
Por exemplo, se o dicionário define que “documento” deve ser validado, a automação pode:
Defina “campos obrigatórios” e regras de inferência quando permitido. Para o que não pode ser inferido, estabeleça o fluxo de exceção.
Um cuidado importante é não “forçar inferência” quando a inferência aumenta risco. Por exemplo, inferir prioridade sem dados suficientes pode gerar SLA errado. Em casos assim, a regra deve assumir “indeterminado” e encaminhar para revisão humana.
O dicionário deve conter o mapeamento entre significados e registrar qual sistema é referência em cada caso. Quando houver conflito, o fluxo de exceção deve ser explícito.
Na prática, divergências podem ser:
O dicionário pode tratar cada tipo com ações diferentes: por exemplo, se for divergência de timing, pode-se aguardar sincronização; se for divergência de interpretação, pode-se abrir incidente sem reprocessar automaticamente.
Este artigo se baseia em conceitos consolidados de governança de dados, qualidade e padronização semântica. Como referência de boas práticas, vale considerar:
Quando você tiver métricas internas ou documentos específicos do seu caso, posso ajudar a traduzir isso em critérios verificáveis e em um plano de implantação coerente com sua realidade.
Além disso, vale mencionar um princípio prático: “o dicionário precisa ser testável”. Em governança e engenharia, documentos que não geram efeito verificável tendem a se tornar apenas referência. Ao construir um dicionário com regras testáveis (inputs/outputs, cenários de exceção e logs de decisão), você reduz a lacuna entre “compreender” e “operar”.
A Automação Dicionario oferece uma forma objetiva de transformar linguagem e conceitos em regras aplicáveis a automações e integrações. Ao focar em padronização semântica, governança e acoplamento prático aos workflows, ela tende a reduzir ambiguidades e a estabilizar decisões automatizadas em ambientes com múltiplas fontes de dados. O ponto decisivo é tratar o dicionário como um produto em evolução: com versionamento, validação do negócio e testes de exceção.
Quando o dicionário é bem desenhado e efetivamente consumido, a organização passa a ter consistência “por design”, não apenas “por esforço humano”. Isso significa que, no longo prazo, a automação não apenas executa mais rápido: ela executa com menos risco de interpretar errado. E esse efeito dominó se estende para manutenção, auditoria e capacidade de escalar a operação com novos sistemas e novos canais.
Em termos práticos, a Automação Dicionario atua como uma ponte entre três mundos que frequentemente divergem: o mundo do negócio (intenção e critérios), o mundo de TI (estruturas e dados) e o mundo da operação (SLAs, filas, triagem e exceções). Ao alinhar significado e decisão, ela reduz retrabalho, encurta ciclos de mudança e torna incidentes mais diagnosticáveis.
Se você quiser, informe: (1) quais sistemas você integra, (2) quais conceitos principais quer padronizar e (3) se há um fornecedor ou faixa de preço já em mente. Com isso, eu adapto o texto para o seu cenário com uma seção de comparação e um plano de execução mais alinhado.



Este guia analisa como a Automação Dicionario apoia padronização, mapeamento de termos e integração de fluxos para reduzir retrabalho e melhorar a governança. Em base objetiva, o texto contextualiza automação, dicionários de dados e requisitos de qualidade. Também detalha um passo a passo de implantação, comparações de abordagem e condições de uso, além de FAQs voltadas a times de processos e TI.
A automação apoiada por um “Automação Dicionario” melhora consistência, reduz retrabalho e acelera decisões. O texto contextualiza, de forma objetiva, o que significa usar dicionários como base de regras e mapeamentos. Em seguida, apresenta critérios para selecionar fornecedores, definir etapas e requisitos, além de uma visão prática sobre governança, qualidade de dados e integração a sistemas.
A automação baseada em “Automação Dicionario” melhora a consistência de regras, padroniza conteúdo e reduz retrabalho em rotinas de processamento de texto e dados. O guia explica, de forma objetiva, o que é automação com dicionário, quais cuidados usar na modelagem e como avaliar fornecedores, capacidades e requisitos técnicos para uma implementação sustentável.
Este guia explica como estruturar o “Automação Dicionario” para padronizar regras, melhorar integrações e reduzir inconsistências operacionais. Em termos objetivos, o conceito envolve organizar terminologia, campos e comportamentos em uma base de conhecimento reutilizável. Também descreve como fornecedores e custos variam conforme escopo, maturidade do ambiente e requisitos de governança, incluindo condições para implantação.
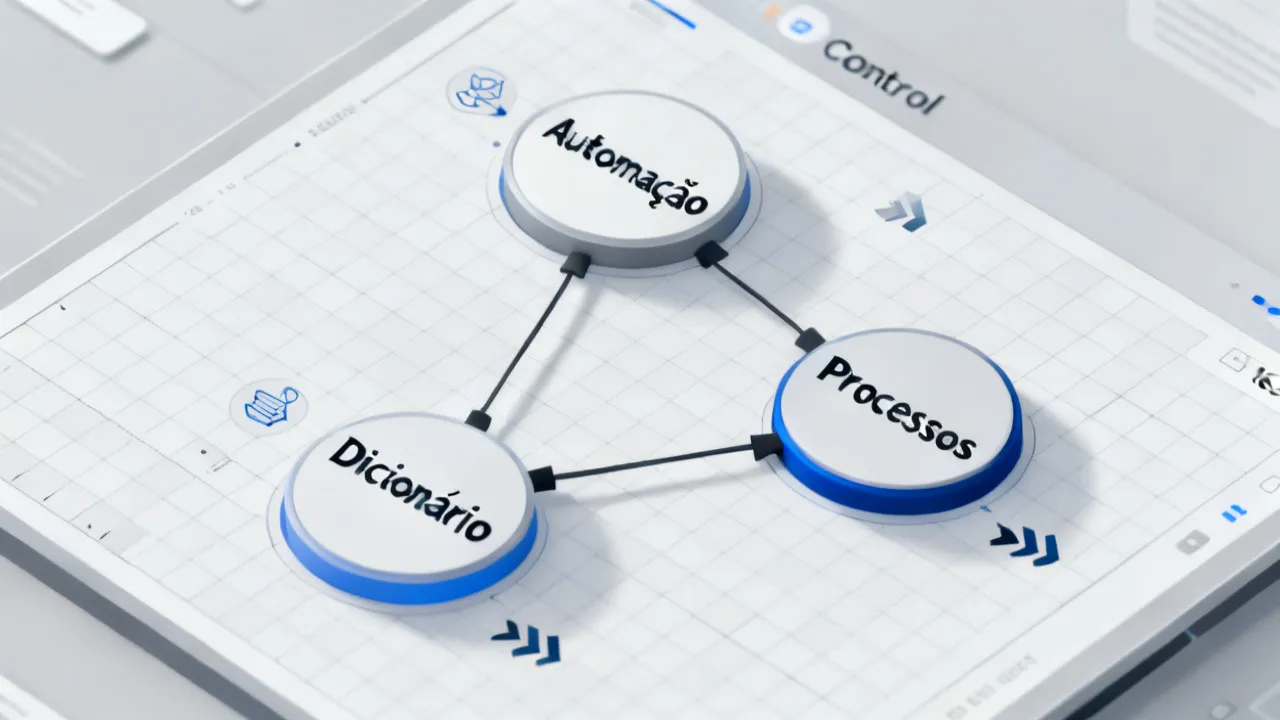
A Automação Dicionario organiza conhecimento e padroniza termos para que sistemas atuem com consistência. O guia explica, de forma objetiva, o que é um dicionário de automação, como ele reduz ambiguidades entre equipes e ferramentas, e por que decisões de mapeamento e governança impactam qualidade, manutenção e rastreabilidade em processos operacionais.
A Automação Dicionario organiza definições, regras e mapeamentos para acelerar integrações e reduzir ambiguidades operacionais. O texto contextualiza, de forma objetiva, o que é um dicionário de automação, como ele apoia padronização de dados e decisões, e quais requisitos organizacionais favorecem a adoção em ambientes de TI e negócios.

